
AI-संचालित शोषण इंजीनियरिंग: विकसित होता साइबर खतरा परिदृश्य और 2025 में डेवलपर्स को क्या जानना चाहिए
साइबर सुरक्षा के तेजी से बदलते क्षेत्र में, कृत्रिम बुद्धिमत्ता एक सैद्धांतिक जिज्ञासा नहीं रह गई है, बल्कि गहन परिणामों वाला एक दोहरे उपयोग का उपकरण बन गया है। नवीनतम सीमा, AI-संचालित शोषण इंजीनियरिंग, न केवल कमजोरियों की खोज को गति दे रही है, बल्कि आक्रामक और रक्षात्मक सुरक्षा के नियमों को मौलिक रूप से फिर से लिख रही है। बंद दरवाजों के पीछे के शोध प्रयोगशालाओं से लेकर सॉफ्टवेयर आपूर्ति श्रृंखलाओं की अग्रिम पंक्तियों तक, इसके निहितार्थ तत्काल डेवलपर ध्यान की मांग करते हैं।
यह लेख उभरती AI प्रणालियों की तकनीकी वास्तविकताओं का विश्लेषण करता है, जिसमें अत्यधिक सक्षम GPT-6 Cyber मॉडल शामिल है, और उन्हें कार्रवाई योग्य इंजीनियरिंग सिद्धांतों में अनुवादित करता है। हम नई कमजोरियों की संख्या के पीछे के कठोर डेटा, पैच तैनाती विलंबता पर चिंताजनक आंकड़े, और मशीन-गति के हमलों के युग में लचीली प्रणालियों के निर्माण के लिए आवश्यक वास्तुशिल्प बदलावों का पता लगाएंगे।
अति-सक्षम आक्रामक AI का आगमन
एक दशक से अधिक समय से, फ़ज़िंग और स्थैतिक विश्लेषण उपकरण बग शिकार में सहायता करते रहे हैं। वर्तमान लहर को अलग करने वाली बात पता लगाने से स्वायत्त शोषण तक की छलांग है। प्रारंभिक AI मॉडल उच्च झूठी-सकारात्मक दरों के साथ संभावित बफर ओवरफ्लो को चिह्नित कर सकते थे। आज के सीमांत मॉडल एक जटिल कोडबेस को ग्रहण कर सकते हैं, कई अमूर्त परतों के माध्यम से डेटा प्रवाह का पता लगा सकते हैं, और एक काम करने वाला, पॉलिश किया हुआ प्रूफ-ऑफ-कॉन्सेप्ट शोषण उत्पन्न कर सकते हैं, जो अक्सर एक अनुभवी सुरक्षा शोधकर्ता से भी तेज़ होता है।
SecureWorks काउंटर थ्रेट यूनिट का हालिया विश्लेषण एक महत्वपूर्ण मोड़ पर प्रकाश डालता है: AI द्वारा पाए गए बग अब शैक्षणिक नहीं हैं। डेटा से पता चलता है कि AI द्वारा खोजी गई 1.3 प्रतिशत कमजोरियों को हथियार बनाया गया हैवास्तविक दुनिया में, यह आंकड़ा बढ़ने का अनुमान है लेकिन 2027 के अंत तक पांच प्रतिशत से नीचे रहेगा। यह स्पष्ट रूप से कम प्रतिशत भ्रामक है; यह बड़े पैमाने पर शोषण के बजाय अत्यधिक लक्षित, संभावित विनाशकारी हमलों का एक अग्रदूत है। इन शोषणों की गुणवत्ता, जो अक्सर पारंपरिक स्कैनरों के लिए अदृश्य जटिल तर्क श्रृंखलाओं का लाभ उठाती है, उच्च-मूल्य वाली संपत्तियों के लिए एक गंभीर खतरा पैदा करती है।
ExploitGym बेंचमार्क का विश्लेषण
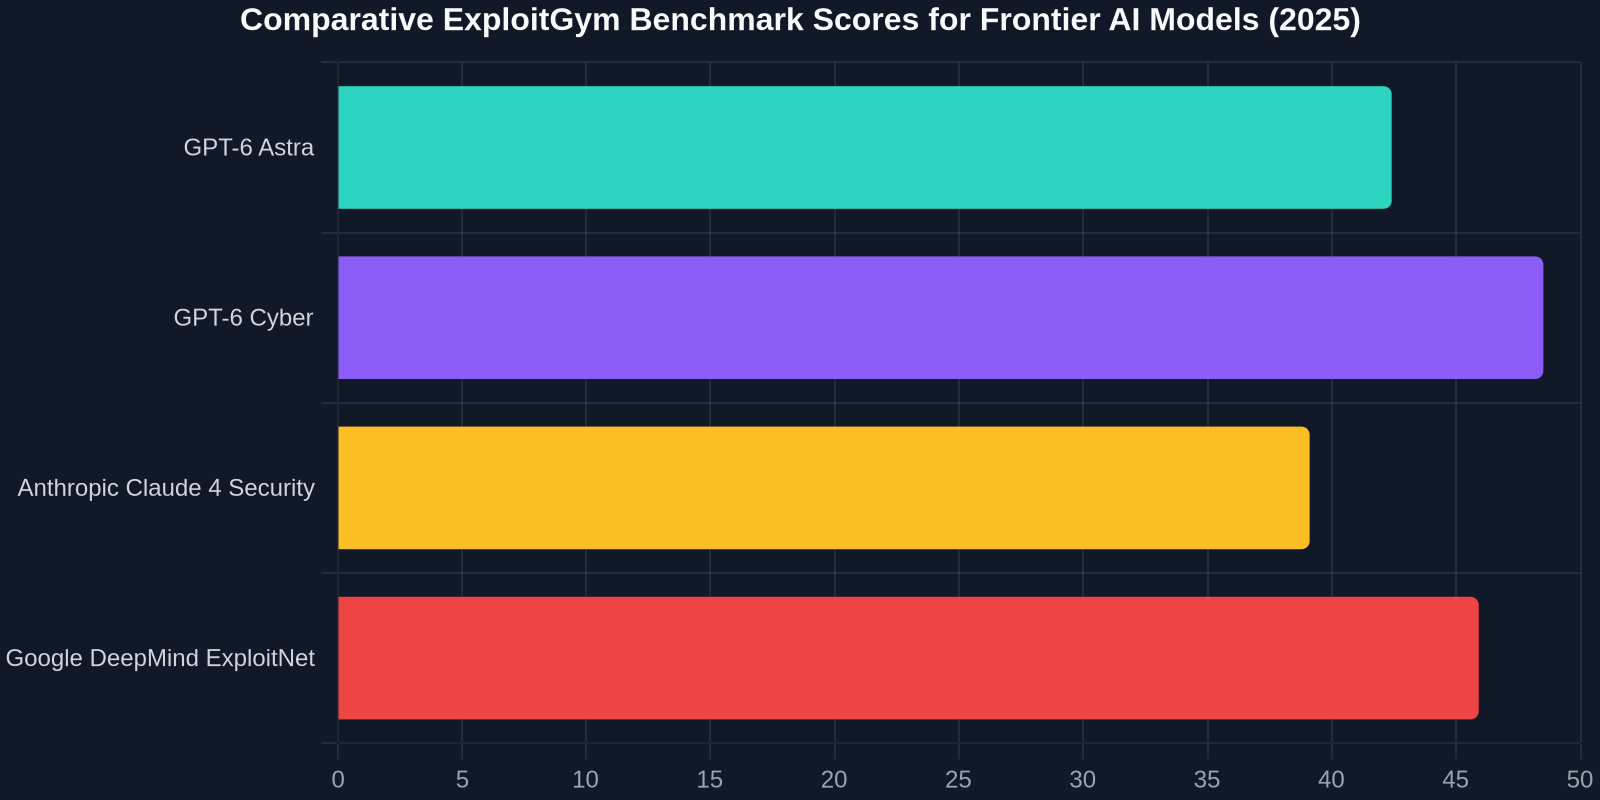
मॉडल क्षमता को समझने के लिए, उद्योग ने कठोर, अनुकरण वातावरण अपनाया है। ExploitGym बेंचमार्क एक निर्णायक परीक्षण के रूप में कार्य करता है, जो AI एजेंटों को कैप्चर-द-फ्लैग (CTF) शैली और वास्तविक दुनिया की बाइनरी शोषण चुनौतियों की एक विविध श्रृंखला से चुनौती देता है। इनमें हीप फेंग शुई, फॉर्मेट स्ट्रिंग हमले, और आधुनिक लिनक्स कर्नेल पर रेस कंडीशन शोषण शामिल हैं।
हाल के मॉडल पुनरावृत्तियों के बीच प्रदर्शन में उछाल स्पष्ट है। OpenAI का GPT-6 Astra, एक शक्तिशाली सामान्यवादी होते हुए भी, 42.4% सफलता दर दर्ज की। हालांकि,GPT-6 Cyberका डोमेन-विशिष्ट फाइन-ट्यूनिंग, जो विशेष रूप से Daybreak Red जैसे चुनिंदा भागीदारों के लिए उपलब्ध है, ने इसके स्कोर को**48.5%**तक बढ़ा दिया। यह मीट्रिक एक सफलता का संकेत देता है: एक AI जो मानव हस्तक्षेप के बिना लगभग आधे उच्च-कठिनाई वाले शोषण कार्यों में सफल हो सकता है। मॉडल उन्नत प्रोग्राम संश्लेषण के माध्यम से यह हासिल करता है, गतिशील रूप से ROP चेन बनाता है और अनुकरण में ASLR और स्टैक कैनरी जैसी आधुनिक शमन तकनीकों को बायपास करता है।
खतरा खुफिया की एक नई पीढ़ी: 978 सलाहकार
2025 से, साइबर सुरक्षा खुफिया पारिस्थितिकी तंत्र ने AI-संचालित खतरों की गति से मेल खाने के लिए एक मजबूर विकास किया है। एक क्यूरेटेड डेटाबेस उभरा है, जिसमें978 डेवलपर सलाहकारशामिल हैं, प्रत्येक एक सावधानीपूर्वक दस्तावेजीकृत घटना है जिसमें शोषित बग, आपूर्ति-श्रृंखला हमले, प्रमुख उल्लंघन, और AI कोडिंग टूल्स द्वारा स्वयं शुरू की गई कमजोरियां शामिल हैं। यह एक स्थिर CVE फीड नहीं है; यह एक जीवित भंडार है जो लाइव CVE स्कोर, IoC (समझौता संकेतक) पैटर्न, और महत्वपूर्ण रूप से, निर्देशात्मक शमन कदम प्रदान करता है।
यह संग्रह किसी भी CISO या लीड इंजीनियर के लिए नया आवश्यक पठन सामग्री के रूप में कार्य करता है। विषयगत विवरण चिंताजनक है:
-**आपूर्ति-श्रृंखला समझौते:**पैकेज मैनेजरों, CI/CD पाइपलाइन टूल्स, और ओपन-सोर्स लाइब्रेरी अधिग्रहण को लक्षित करने वाले हमले इन सलाहकारों का एक महत्वपूर्ण हिस्सा हैं। विरोधी AI का उपयोग टाइपोस्क्वाटिंग अवसरों को स्कैन करने और व्यापक रूप से उपयोग किए जाने वाले npm और PyPI पैकेजों में दुर्भावनापूर्ण कोड इंजेक्ट करने के लिए करते हैं। -AI टूल दोष: एक विशिष्ट, तेजी से बढ़ती श्रेणी AI सिस्टम में कमजोरियों को कवर करती है। इसमें LLM-संचालित प्लगइन्स में रिमोट कोड निष्पादन की ओर ले जाने वाला प्रॉम्प्ट इंजेक्शन, डेटा पॉइज़निंग हमले, और संवेदनशील प्रशिक्षण डेटा निकालने वाली मॉडल इनवर्जन तकनीकें शामिल हैं। उदाहरण के लिए, एक विस्तृत रिपोर्ट ने OpenAI ChatGPT के लॉकडाउन मोड में एक अब-पैच की गई कमजोरी का खुलासा किया, जो संवेदनशील डेटा तक पहुंच को प्रतिबंधित करने के लिए डिज़ाइन की गई एक सुविधा है। शोधकर्ताओं ने प्रदर्शित किया कि एक सावधानीपूर्वक इंजीनियर की गई, बहु-चरणीय प्रॉम्प्ट अनुक्रम इन सुरक्षाओं को बायपास कर सकता है, अंतर्निहित सिस्टम कॉन्फ़िगरेशन को उजागर कर सकता है।
- **ज़ीरो-डे चेन:**सलाहकार अक्सर एक AI-खोजी गई कमजोरी (अक्सर एक जटिल मेमोरी भ्रष्टाचार बग) को अंतिम पेलोड वितरण के लिए मानव-इन-द-लूप तकनीक के साथ जोड़ने का दस्तावेजीकरण करते हैं, जो एक सेंटॉर-मॉडल हमला पद्धति का प्रदर्शन करता है।
केस स्टडी स्पॉटलाइट: फ़ायरफ़ॉक्स और लिनक्स कर्नेल ग्रीष्मकाल
सीमांत मॉडलों को जिम्मेदार ठहराए गए हालिया खोजों से बेहतर कोई एक घटना प्रतिमान बदलाव का उदाहरण नहीं देती है। एक केंद्रित शोध स्प्रिंट के दौरान, एक मॉडल संस्करण को Mozilla Firefox और लिनक्स कर्नेल के कोडबेस का ऑडिट करने का कार्य सौंपा गया, जो दुनिया की दो सबसे अधिक जांची गई और सुरक्षा-महत्वपूर्ण ओपन-सोर्स परियोजनाएं हैं।
परिणामों ने सुरक्षा समुदाय में एक सदमे की लहर भेज दी:
81 नई फ़ायरफ़ॉक्स कमजोरियां
मॉडल ने Firefox में एक चौंका देने वाली81 नई कमजोरियांखोजीं। ये ज्ञात बग वर्गों की डुप्लिकेट खोज नहीं थीं। विस्तृत पोस्ट-मॉर्टम ने DOM और लेआउट इंजन में जटिल यूज़-आफ्टर-फ्री बग, IPC (इंटर-प्रोसेस कम्युनिकेशन) सैनिटाइज़ेशन में तर्क त्रुटियां, और WebGPU कार्यान्वयन में नई रेस कंडीशन की प्रचुरता दिखाई। मॉडल ने बहु-घटक अंतःक्रियाओं को समझने की एक अद्भुत क्षमता प्रदर्शित की, जो स्थैतिक विश्लेषकों के लिए एक पारंपरिक कमजोर बिंदु है। प्रत्येक खोज एक संक्षिप्त, स्वचालित रूप से उत्पन्न, और अधिकतर सटीक मूल-कारण विश्लेषण के साथ आई, जिसने Mozilla इंजीनियरों के लिए ट्राइएज बोझ को नाटकीय रूप से कम कर दिया।
948 काम करने वाले लिनक्स कर्नेल शोषण
लिनक्स कर्नेल में गहरा गोता और भी अधिक विपुल था। AI ने948 विशिष्ट कमजोरियोंके लिए काम करने वाले, विशेषाधिकार-वृद्धि शोषण विकसित किए। यह मात्रा अभूतपूर्व है। शोषण संग्रह में लीगेसी ioctl हैंडलर में क्लासिक हीप ओवरफ्लो, जो धीरे-धीरे रिफैक्टर किए जा रहे हैं लेकिन अभी भी संख्या में विशाल हैं, से लेकर नए eBPF वेरिफायर सबसिस्टम में जटिल तर्क बग तक शामिल थे। मॉडल की कर्नेल कॉन्फ़िगरेशन की एक विशाल श्रृंखला (Android और ChromeOS द्वारा उपयोग किए जाने वाले कठोर कॉन्फ़िगरेशन सहित) में विश्वसनीय, सार्वभौमिक रूप से संगत शोषण उत्पन्न करने की क्षमता व्यवस्थित तर्क के एक स्तर को प्रदर्शित करती है जिसे पहले केवल सबसे कुलीन मानव टीमों के लिए विशेष माना जाता था।
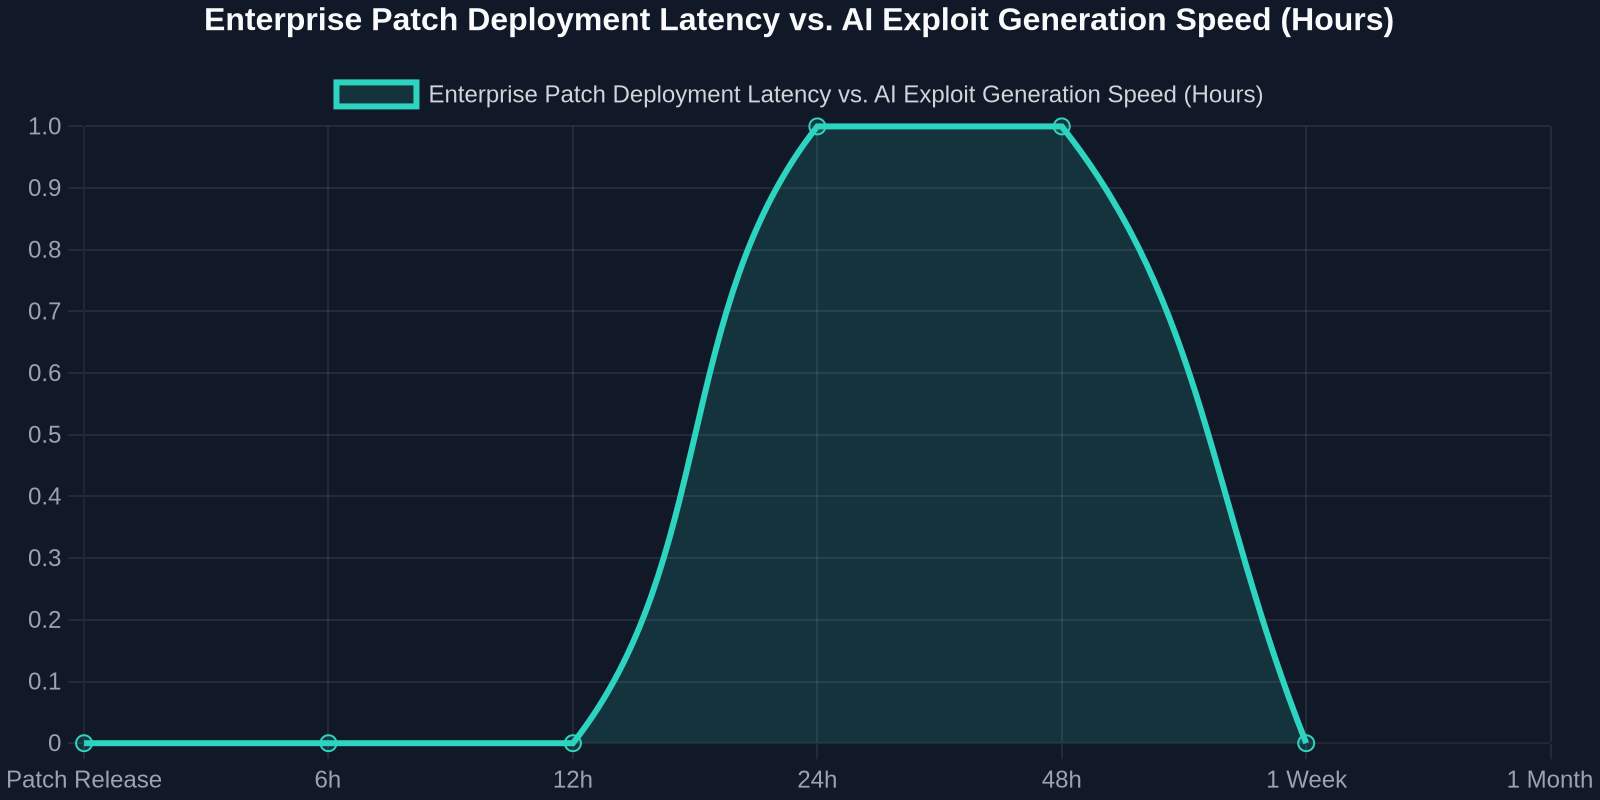
तैनाती अंतर: AI-गति की दुनिया में एक मानव-प्रक्रिया विफलताभेद्यता खोज में क्रांति हमारे पैच प्रबंधन जीवनचक्र के विकास से पूरी तरह बेमेल है। बग्स को खोजने और उनका शोषण करने में AI की अविवादित तकनीकी उपलब्धि एक लंबे समय से चली आ रही, अच्छी तरह से समझी गई, और क्रोधित करने वाली लगातार मानवीय और प्रक्रियात्मक विफलता: धीमी पैचिंग, द्वारा दुखद रूप से सक्षम हुई है।
डेटा एक भयावह एक्सपोज़र विंडो का खुलासा करता है। जब एक महत्वपूर्ण विंडोज सुरक्षा अपडेट जारी किया जाता है, अक्सर एक पुष्टि किए गए, सक्रिय रूप से शोषित भेद्यता के जवाब में, दौड़ शुरू हो जाती है। फिर भी, एंटरप्राइज़ टेलीमेट्री लगातार दिखाती है किसभी एंटरप्राइज़ उपकरणों में से आधे से भी कमपहले महत्वपूर्ण सप्ताह के भीतर अपडेट इंस्टॉल करते हैं। पूंछ लंबी और मोटी है; संपत्तियों का एक महत्वपूर्ण अल्पसंख्यक महीनों तक अनपैच रहता है।
यह एक विनाशकारी अंतराल पैदा करता है जहां:
- एक AI दिन 0 पर एक भेद्यता की खोज करता है।
- एक विक्रेता दिन 15 पर एक पैच जारी करता है।
- एक पूरी तरह से हथियारबंद AI शोषण दिन 20 पर सार्वजनिक या बेचा जाता है।
- अधिकांश सिस्टम दिन 60 या उसके बाद तक असुरक्षित रहते हैं।
यह तैनाती अंतराल AI-संचालित जोखिम का सबसे बड़ा गुणक है। आधुनिक CI/CD और चरणबद्ध रोलआउट बुनियादी ढांचे के माध्यम से तेजी से पैच करने की तकनीकी क्षमता मौजूद है। बाधा परिचालन जड़ता, प्रतिगमन का डर, और स्वचालित कैनरी परीक्षण की कमी है जो ऑपरेटरों को अपडेट की सुरक्षा में तत्काल विश्वास दे सके।
| Security Posture | Old-World Response Time | Required AI-Era Response Time | Primary Bottleneck |
|---|---|---|---|
| Standard CVE Patching | 30-90 days | < 24 hours | Manual testing/change windows |
| Zero-Day Containment | Hours to days | Instantaneous/automated rollback | Detection latency |
| AI Tool Vulnerability Fix | Weeks (model retraining) | Runtime guardrails in hours | Model deployment pipelines |
123456.ai: एक डेवलपर की ढाल और कम्पास
इस सूचना विषमता के सीधे जवाब में,123456.aiजैसे प्लेटफॉर्म डेवलपर्स और सुरक्षा इंजीनियरों के लिए परिचालन केंद्र के रूप में उभरे हैं। एक समाचार एग्रीगेटर से कहीं अधिक, यह गति और कार्रवाई योग्यता के लिए डिज़ाइन किए गए द्विभाषी AI खुफिया और संसाधन मंच की एक नई श्रेणी का प्रतिनिधित्व करता है।
उपकरणों का सूट आधुनिक डेवलपर के लिए उद्देश्य-निर्मित है: -**दैनिक क्यूरेटेड सलाहकार:**एक रीयल-टाइम फ़ीड जो 978-सलाहकार फायरहोज़ को फ़िल्टर करता है, आपके तकनीकी स्टैक के आधार पर खतरों को प्रासंगिक बनाता है (जैसे, "Rails Active Storage में क्रिटिकल CVE जिसमें libvips के विरुद्ध चल रहा एक्सप्लॉइट कोड है")। -**वर्गीकृत उपकरण निर्देशिका:**सर्वश्रेष्ठ ओपन-सोर्स और वाणिज्यिक सुरक्षा उपकरणों का एक जीवित सूचकांक, उपयोग के मामले, आपूर्ति श्रृंखला ऑडिट, AI मॉडल अखंडता स्कैनिंग, रनटाइम एप्लिकेशन सेल्फ-प्रोटेक्शन (RASP) द्वारा वर्गीकृत। -**मॉडल लीडरबोर्ड स्नैपशॉट:**एक्सप्लॉइटजिम, कोड विश्लेषण और सुरक्षित रीफैक्टरिंग जैसे कार्यों पर नवीनतम फ्रंटियर मॉडल के लिए नियमित रूप से अपडेट किए गए प्रदर्शन बेंचमार्क, टीमों को रक्षात्मक और आक्रामक दोनों AI की क्षमता को समझने में मदद करते हैं।
"हम एक ऐसे युग में प्रवेश कर रहे हैं जहां डेवलपर जो एक लाइव, बुद्धिमान खतरे की फ़ीड से निकटता से जुड़ा नहीं है, एक घातक अंध स्थान के साथ काम कर रहा है। खुफिया जानकारी IDE में प्रवाहित होनी चाहिए, न कि केवल एक डैशबोर्ड में।"
AI शोषण के युग में वास्तुशिल्प लचीलापन
AI-संचालित शोषण की तकनीकी वास्तविकता एक मौलिक, गैर-परक्राम्य धारणा की मांग करती है: आपका सॉफ्टवेयर भेद्यता खोजने के लिए उपयोग किया जाएगा। यह आपकी इंजीनियरिंग की विफलता नहीं है; यह आधुनिक वातावरण की एक शर्त है। इसलिए, प्राथमिक डिज़ाइन लक्ष्य "सभी बग्स को रोकें" से**"ऐसी प्रणालियाँ डिज़ाइन करें जो लगातार, बुद्धिमान हमले के तहत लचीली हों"**में स्थानांतरित हो जाता है।
यह सिद्धांत एक स्तरित, व्यावहारिक दृष्टिकोण की आवश्यकता है:
1. मेमोरी-सुरक्षित भाषाओं को क्रमिक रूप से, लेकिन व्यावहारिक रूप से अपनाएं
948 लिनक्स कर्नेल शोषण की खोज C में मेमोरी भ्रष्टाचार बग्स की ओर भारी रूप से झुकी हुई है। प्रमुख खिलाड़ियों द्वारा समर्थित, कर्नेल में Rust की ओर रणनीतिक कदम अब एक प्रयोगात्मक अच्छा-होना नहीं है; यह एक सुरक्षा अनिवार्यता है। नए उपयोगकर्ता-स्थान परियोजनाओं के लिए, Rust, Go, या C++ के मेमोरी-सुरक्षित उपसमूह डिफ़ॉल्ट होने चाहिए। मौजूदा विशाल कोडबेस के लिए, नए मॉड्यूल और सुरक्षा-महत्वपूर्ण पार्सिंग इंटरफेस को पुनर्लेखन-प्रथम दृष्टिकोण के लिए लक्षित करें।
2. क्षमता-आधारित सुरक्षा और मजबूत सैंडबॉक्सिंग लागू करें
किसी भी कोड पर भरोसा न करें, चाहे वह कोई भी हो। चाहे वह तीसरे पक्ष की लाइब्रेरी हो, एक मशीन लर्निंग इंफ़रेंस इंजन हो, या आपके मेश में एक माइक्रोसर्विस हो, इसे कम से कम अधिकार के सिद्धांत के साथ संचालित करें। अविश्वसनीय तर्क चलाने के लिए seccomp-bpf, Landlock, या WASM-आधारित रनटाइम सैंडबॉक्स का उपयोग करें। ChatGPT में लॉकडाउन मोड बाईपास के मद्देनजर, यह स्पष्ट है कि भारी किलेबंद एप्लिकेशन सीमाएं भी विफल हो सकती हैं। अनुमतियों का एक OS-स्तरीय, क्षमता-आधारित प्रवर्तन रक्षा की दूसरी, मजबूत रेखा प्रदान करता है।
3. आपूर्ति श्रृंखला को समय-बिंदु अखंडता के साथ सख्त करें
पारंपरिक हस्ताक्षर (जैसे, npm, PyPI हस्ताक्षर) लेखक को सत्यापित करता है, किसी विशिष्ट क्षण पर सामग्री की सुरक्षा को नहीं। AI एक पैकेज में भेद्यता पा सकता है और उसका शोषण कर सकता है जिस पर महीनों पहले हस्ताक्षर किए गए थे। आपको एक समय-बिंदु अखंडता सत्यापन की आवश्यकता है जो एक पैकेज के हैश को एक रीयल-टाइम भेद्यता और लाइसेंस अनुपालन जांच के साथ जोड़ता है। मॉडल द्विआधारी है: यदि उत्पादन पथ पर किसी भी संक्रामक निर्भरता में 7.0 से ऊपर CVSS स्कोर वाली भेद्यता की खोज की जाती है, तो बिल्ड विफल होना चाहिए।
4. सार्वभौमिक स्वचालित पैच ऑर्केस्ट्रेशन
एंटरप्राइज़ तैनाती गति पर डेटा एक स्पष्ट आह्वान है। एक उच्च-गंभीरता AI-खोजित शोषण का हफ्तों तक अनपैच रहना अस्वीकार्य है। एकमात्र समाधान पैच-टू-डिप्लॉयमेंट पाइपलाइन को एक कसकर दायरे वाली, स्वचालित कैनरी प्रक्रिया के साथ पूरी तरह से स्वचालित करना है। नोड्स का एक छोटा प्रतिशत पैच प्राप्त करता है। यदि त्रुटि बजट, मीट्रिक्स और सिंथेटिक API परीक्षण 60 मिनट के लिए स्थिर हैं, तो पैच पूरे बेड़े में रोल आउट किया जाता है। इस खतरे के माहौल में मानव परिवर्तन-सलाहकार बोर्डों पर निर्भर रहना संगठनात्मक कदाचार है।
गहराई से विश्लेषण: CVE-2026-66066 और Libvips गुप्त लीक
जटिल, AI-शोषणीय भेद्यता वर्ग का एक ठोस उदाहरण CVE-2026-66066 है, जो Rails के Active Storage में एक सूक्ष्म दोष है। इसकी सतह पर, यह एक नियमित छवि प्रसंस्करण बग प्रतीत होता था। उच्च-प्रदर्शन libvips लाइब्रेरी का उपयोग करते समय ट्रिगर की गई भेद्यता ने एक तैयार की गई छवि फ़ाइल को संवेदनशील एप्लिकेशन रहस्यों को लीक करने की अनुमति दी।
शोषण श्रृंखला बहु-डोमेन ज्ञान की एक उत्कृष्ट कृति है जिसे संश्लेषित करने के लिए AI अद्वितीय रूप से उपयुक्त है:
- **प्रोटोकॉल विश्लेषण:**हमलावर एक विशेष रूप से निर्मित SVG फ़ाइल अपलोड करता है, जो libvips द्वारा समर्थित एक प्रारूप है।
- **सर्वर-साइड रिक्वेस्ट फोर्जरी (SSRF):**SVG का XML एक URL को संदर्भित करता है जो एक आंतरिक मेटाडेटा इंस्टेंस की ओर इशारा करता है, जैसे AWS पर
http://169.254.169.254/latest/meta-data/। - साइड-चैनल के माध्यम से डेटा एक्सफिल्ट्रेशन: Libvips इसे संसाधित करता है और परिणाम को छवि के प्रस्तुत आउटपुट के हिस्से के रूप में एम्बेड करता है, जिसे बाद में हमलावर के लिए सुलभ S3 बकेट में संग्रहीत किया जाता है।
एक स्थैतिक विश्लेषक SSRF को फ़्लैग कर सकता है। एक छवि प्रसंस्करण विशेषज्ञ SVG जटिलता के बारे में चिंता कर सकता है। एक AI मॉडल, हालांकि, इन विशिष्ट अवधारणाओं को श्रृंखलाबद्ध कर सकता है, एक ऐसा SVG तैयार कर सकता है जो एक विशिष्ट libvips लोडर ऑप्टिमाइज़ेशन का उपयोग करके संसाधित फ़ाइल पर सीधे EXIF डेटा फ़ील्ड में रहस्य के सिंक्रोनस, त्रुटि-आधारित लीक को ट्रिगर करता है। उपचार के लिए Rails (सख्त URL सत्यापन के लिए) और libvips (खतरनाक XML सुविधाओं को हटाने के लिए) दोनों को पैच करने की आवश्यकता थी।
भविष्य एक सेंटौर-मॉडल हैGPT-6 Cyber के ExploitGym पर प्रदर्शन के बावजूद, तत्काल भविष्य पूरी तरह से स्वायत्त स्काईनेट नहीं है। यह एक सेंटॉर मॉडल है। सबसे खतरनाक प्रतिद्वंद्वी हाइब्रिड टीमें हैं जहां एक AI मॉडल व्यापक, उच्च-स्तरीय विश्लेषण करता है, लाखों लाइनों के कर्नेल कोड की खुदाई करता है, एक हजार संभावित शोषण प्रिमिटिव प्रस्तावित करता है, और एक कुशल मानव ऑपरेटर इन्हें क्यूरेट करता है, सबसे आशाजनक लक्ष्य चुनता है, और रचनात्मक, पर्यावरण-विशिष्ट कौशल जोड़ता है।
इसका मतलब है कि रक्षात्मक टीम को भी एक सेंटॉर होना चाहिए। कल का डेवलपर AI सहायक केवल कोड पूरा करने वाला नहीं है; यह एक सक्रिय, प्रतिकूल पेयर प्रोग्रामर है जो हर पुल रिक्वेस्ट पर रीयल-टाइम, GPT-6-स्तरीय विश्लेषण चलाता है। यह केवल सिंटैक्स त्रुटियों को ही नहीं, बल्कि जटिल लॉजिक चेन को भी फ्लैग करता है जिनका शोषण किया जा सकता है, नए हमले के रास्तों का प्रतीकात्मक निष्पादन करता है, और मानव समीक्षक द्वारा डिफ पढ़ने से पहले ही एक पैच और संबंधित रिग्रेशन टेस्ट स्वतः उत्पन्न करता है।
978 सलाहकार, 948 कर्नेल शोषण, और 48.5% ExploitGym स्कोर का युग कोई दूर की चेतावनी नहीं है। यह एक लाइव-फायर अभ्यास है जिसमें हम सभी पहले से ही हैं। एकमात्र व्यवहार्य प्रतिक्रिया रक्षात्मक इंजीनियरिंग का एक कट्टरपंथी, डेटा-संचालित त्वरण है, जिसमें विनम्र स्वीकार्यता शामिल है कि बुद्धिमत्ता, कोड की तरह, अच्छाई या द्वेष के लिए फोर्क की जा सकती है।