
AI-gestuurde Exploit Engineering: Het Evoluerende Cyberdreigingslandschap en Wat Ontwikkelaars Moeten Weten in 2025
In het snel veranderende veld van cybersecurity is kunstmatige intelligentie opgehouden een theoretische nieuwsgierigheid te zijn en is het een tweesnijdend instrument van grote betekenis geworden. Het nieuwste front, AI-gestuurde exploit engineering, versnelt niet alleen de ontdekking van kwetsbaarheden, maar herschrijft fundamenteel de regels van offensieve en defensieve beveiliging. Van besloten onderzoekslaboratoria tot de frontlinies van softwareleveringsketens, de implicaties vereisen onmiddellijke aandacht van ontwikkelaars.
Dit artikel ontleedt de technische realiteiten van opkomende AI-systemen, waaronder het zeer capabele GPT-6 Cyber-model, en vertaalt ze naar bruikbare technische principes. We zullen de harde gegevens achter nieuwe kwetsbaarheidsaantallen verkennen, de verontrustende statistieken over patchimplementatievertraging, en de architecturale verschuivingen die nodig zijn om veerkrachtige systemen te bouwen in een tijdperk van aanvallen op machinesnelheid.
De Komst van Hypercapabele Offensieve AI
Al meer dan tien jaar helpen fuzzing- en statische analysetools bij het opsporen van bugs. Wat de huidige golf onderscheidt, is de sprong van detectie naar autonome exploitatie. Vroege AI-modellen konden potentiële bufferoverflows markeren met hoge fout-positieve percentages. De huidige grensmodellen kunnen een complexe codebase verwerken, datastromen door meerdere abstractielagen volgen en een werkende, gepolijste proof-of-concept-exploit genereren, vaak sneller dan een ervaren beveiligingsonderzoeker.
De recente analyse van de SecureWorks Counter Threat Unit benadrukt een kritiek omslagpunt: door AI gevonden bugs zijn niet langer academisch. De gegevens tonen aan dat 1,3 procent van de door AI ontdekte kwetsbaarheden is bewapendin het wild, een cijfer dat naar verwachting zal stijgen maar onder de vijf procent blijft tot eind 2027. Dit schijnbaar lage percentage is misleidend; het vertegenwoordigt een voorhoede van zeer gerichte, potentieel catastrofale aanvallen in plaats van bulkexploitatie. De kwaliteit van deze exploits, die vaak gebruikmaken van complexe logische ketens die onzichtbaar zijn voor traditionele scanners, vormt een ernstige bedreiging voor hoogwaardige activa.
Het Ontleden van de ExploitGym Benchmark
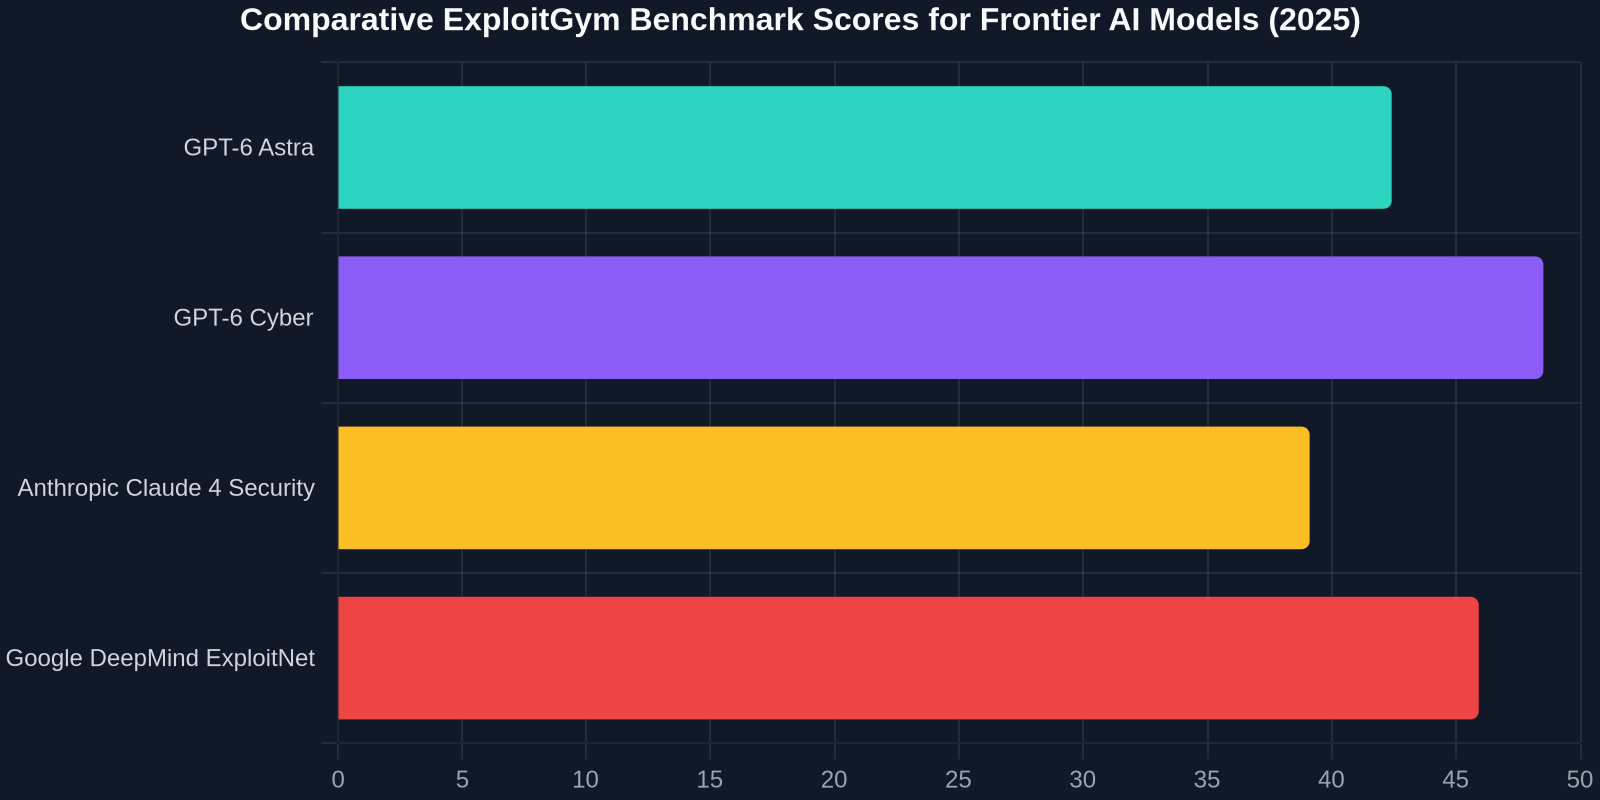
Om de modelcapaciteit te begrijpen, heeft de industrie rigoureuze, gesimuleerde omgevingen aangenomen. De ExploitGym-benchmark dient als een definitieve test, waarbij AI-agenten worden uitgedaagd met een breed scala aan capture-the-flag (CTF)-stijl en real-world binaire exploitatie-uitdagingen. Deze omvatten heap feng shui, format string-aanvallen en race condition-exploitatie op moderne Linux-kernels.
De sprong in prestaties tussen recente modeliteraties is opvallend. OpenAI's GPT-6 Astra, hoewel een krachtige generalist, behaalde een succespercentage van 42,4%. De domeinspecifieke fine-tuning vanGPT-6 Cyber, exclusief beschikbaar voor geselecteerde partners zoals Daybreak Red, verhoogde de score naar 48,5%. Deze maatstaf betekent een doorbraak: een AI die in bijna de helft van alle zeer moeilijke exploitatie-taken kan slagen zonder menselijke tussenkomst. Het model bereikt dit door geavanceerde programsynthese, dynamisch opbouwen van rop-ketens en het omzeilen van moderne mitigaties zoals ASLR en stack canaries in simulatie.
Een Nieuwe Generatie Dreigingsinformatie: De 978 Advisories
Sinds 2025 heeft het cybersecurity-intelligentie-ecosysteem een gedwongen evolutie ondergaan om gelijke tred te houden met de snelheid van AI-gestuurde dreigingen. Er is een samengestelde database ontstaan die 978 ontwikkelaarsadvisoriesomvat, elk een minutieus gedocumenteerd incident dat betrekking heeft op misbruikte bugs, supply-chain-aanvallen, grote inbreuken en kwetsbaarheden die door AI-codetools zelf zijn geïntroduceerd. Dit is geen statische CVE-feed; het is een levende repository die live CVE-scores, IoC (Indicator of Compromise)-patronen en, cruciaal, voorschrijvende mitigatiestappen biedt.
Dit compendium dient als de nieuwe essentiële lectuur voor elke CISO of lead engineer. De thematische uitsplitsing is alarmerend:
-**Supply-Chain-compromissen:**Aanvallen gericht op pakketbeheerders, CI/CD-pijplijntools en overnames van open-sourcebibliotheken vormen een aanzienlijk deel van deze advisories. Tegenstanders gebruiken AI om te scannen op typosquatting-mogelijkheden en kwaadaardige code te injecteren in veelgebruikte npm- en PyPI-pakketten. -AI-toolfouten: Een specifieke, snelgroeiende categorie omvat kwetsbaarheden in AI-systemen. Dit omvat prompt-injectie die leidt tot externe code-uitvoering in LLM-aangedreven plugins, datapoisoning-aanvallen en modelinversietechnieken die gevoelige trainingsgegevens extraheren. Een gedetailleerd rapport onthulde bijvoorbeeld een inmiddels gepatchte kwetsbaarheid in OpenAI ChatGPT's Lockdown Mode, een functie die is ontworpen om toegang tot gevoelige gegevens te beperken. Onderzoekers toonden aan dat een zorgvuldig geconstrueerde, multi-turn prompt-reeks deze bescherming kon omzeilen, waardoor onderliggende systeemconfiguraties werden blootgelegd.
- **Zero-Day-ketens:**De advisories documenteren vaak het koppelen van een door AI ontdekte kwetsbaarheid (vaak een complexe geheugencorruptiebug) met een human-in-the-loop-techniek voor uiteindelijke payload-levering, wat een centaur-model aanvalsmethodologie laat zien.
Casestudy Spotlight: De Firefox en Linux Kernel Zomer
Geen enkele gebeurtenis illustreert de paradigmaverschuiving beter dan de recente ontdekkingen die worden toegeschreven aan grensmodellen. Tijdens een geconcentreerde onderzoekssprint kreeg een modelvariant de taak om de codebases van Mozilla Firefox en de Linux-kernel te auditen, twee van 's werelds meest onderzochte en beveiligingskritieke open-sourceprojecten.
De resultaten stuurden een schokgolf door de beveiligingsgemeenschap:
81 Nieuwe Firefox-kwetsbaarheden
Het model ontdekte maar liefst81 nieuwe kwetsbaarhedenin Firefox. Dit waren geen dubbele bevindingen van bekende bugklassen. De gedetailleerde post-mortem toonde een overvloed aan complexe use-after-free bugs in de DOM en layout-engine, logische fouten in IPC (Inter-Process Communication)-sanering, en nieuwe race conditions in de WebGPU-implementatie. Het model toonde een griezelig vermogen om multi-component interacties te begrijpen, een traditioneel zwak punt voor statische analyzers. Elke bevinding ging gepaard met een beknopte, automatisch gegenereerde en grotendeels nauwkeurige root-cause-analyse, waardoor de triage-last voor Mozilla-ingenieurs aanzienlijk werd verminderd.
948 Werkende Linux Kernel Exploits
De diepgaande analyse van de Linux-kernel was nog productiever. De AI ontwikkelde werkende privilege-escalatie-exploits voor948 verschillende kwetsbaarheden. Deze omvang is ongekend. Het exploit-corpus varieerde van klassieke heap-overflows in legacy ioctl-handlers, die langzaam worden gerefactored maar nog steeds talrijk zijn, tot ingewikkelde logische bugs in nieuwe eBPF-verifier-subsystemen. Het vermogen van het model om betrouwbare, universeel compatibele exploits te genereren over een breed scala aan kernelconfiguraties (inclusief geharde zoals die gebruikt door Android en ChromeOS) toont een niveau van systematisch redeneren dat voorheen exclusief werd geacht voor de meest elite menselijke teams.
De Implementatiekloof: Een Menselijk-Procesfalen in een AI-SnelheidswereldDe revolutie in het ontdekken van kwetsbaarheden is volledig uit de pas met de evolutie van onze levenscycli voor patchbeheer. De onmiskenbare technische prestatie van AI bij het vinden en misbruiken van bugs wordt tragisch mogelijk gemaakt door een al lang bestaand, goed begrepen en tergend hardnekkig menselijk en procesmatig falen: traag patchen.
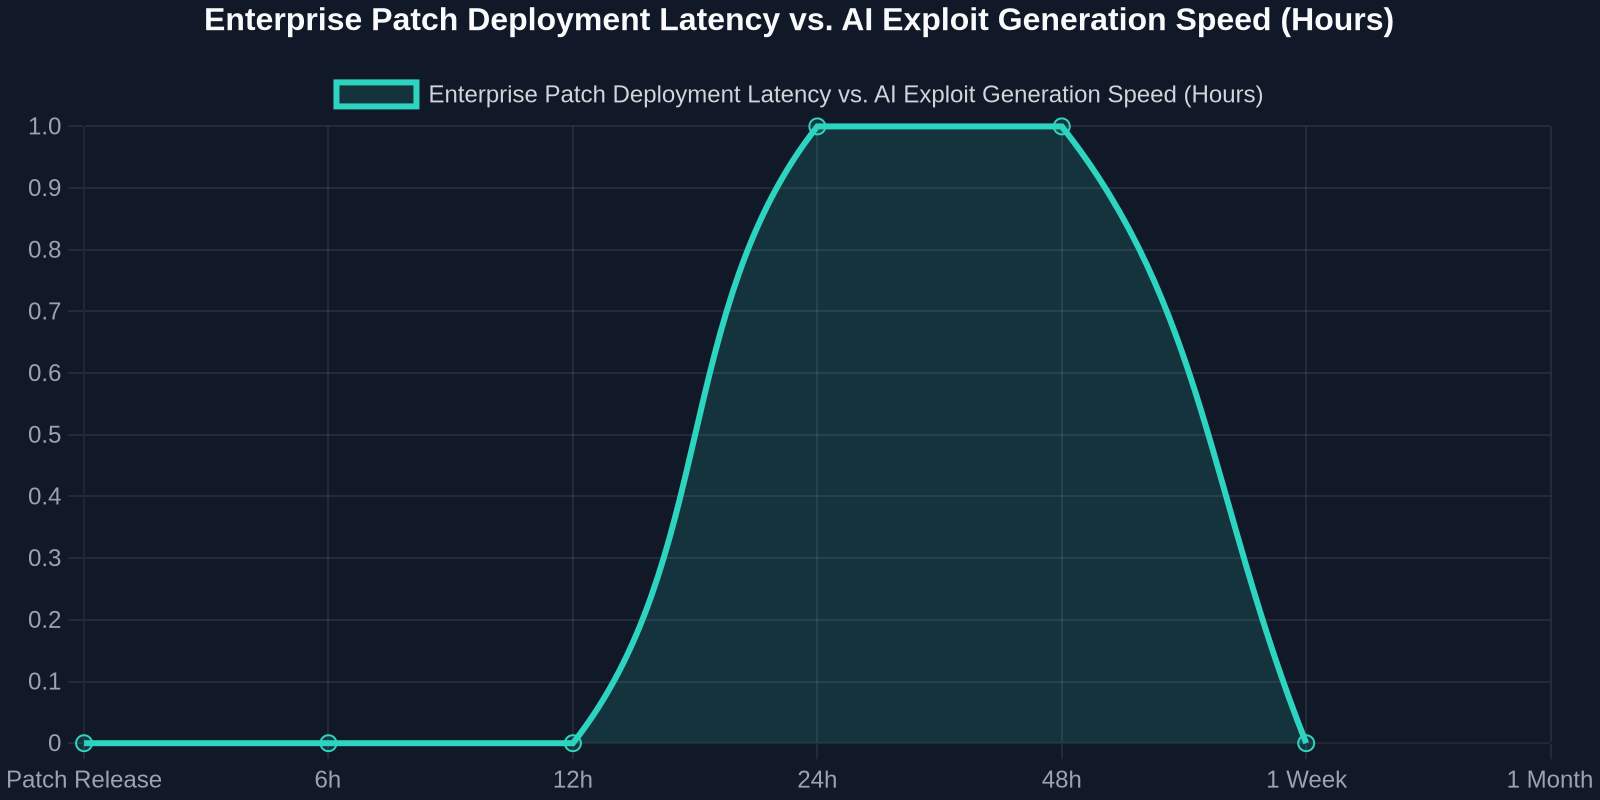
Data onthult een huiveringwekkend blootstellingsvenster. Wanneer een kritieke Windows-beveiligingsupdate wordt uitgebracht, vaak als reactie op een bevestigde, actief misbruikte kwetsbaarheid, is de race begonnen. Toch laat enterprise-telemetrie consequent zien dat minder dan de helft van alle enterprise-apparatende update binnen de eerste kritieke week installeert. De staart is lang en dik; een aanzienlijke minderheid van de assets blijft maandenlang ongepatcht.
Dit creëert een catastrofale vertraging waarbij:
- Een AI een kwetsbaarheid ontdekt op Dag 0.
- Een leverancier een patch uitbrengt op Dag 15.
- Een volledig bewapende AI-exploit openbaar wordt gemaakt of wordt verkocht op Dag 20.
- Een meerderheid van de systemen kwetsbaar blijft tot Dag 60 of later.
Deze implementatiekloof is de grootste vermenigvuldiger van AI-gestuurd risico. De technische mogelijkheid om snel te patchen bestaat via moderne CI/CD en gefaseerde uitrolinfrastructuur. De barrière is operationele inertie, angst voor regressie en een gebrek aan geautomatiseerd canary-testen dat operators onmiddellijk vertrouwen kan geven in de veiligheid van de update.
| Security Posture | Old-World Response Time | Required AI-Era Response Time | Primary Bottleneck |
|---|---|---|---|
| Standard CVE Patching | 30-90 days | < 24 hours | Manual testing/change windows |
| Zero-Day Containment | Hours to days | Instantaneous/automated rollback | Detection latency |
| AI Tool Vulnerability Fix | Weeks (model retraining) | Runtime guardrails in hours | Model deployment pipelines |
123456.ai: Een Schild en Kompas voor Ontwikkelaars
Als direct antwoord op deze informatie-asymmetrie zijn platforms zoals123456.aiontstaan als operationele hubs voor ontwikkelaars en security engineers. Veel meer dan een nieuwsaggregator vertegenwoordigt het een nieuwe categorie van tweetalige AI-informatie- en resourceplatforms, ontworpen voor snelheid en actiegerichtheid.
De reeks tools is speciaal gebouwd voor de moderne ontwikkelaar: -**Dagelijks Gecureerde Advisories:**Een real-time feed die de 978-advisory-brandslang filtert en bedreigingen contextualiseert op basis van jouw tech stack (bijv. "Critical CVE in Rails Active Storage met exploitcode in het wild die tegen libvips draait"). -**Gecategoriseerde Tools Directory:**Een levende index van de beste open-source en commerciële beveiligingstools, gecategoriseerd op use case, supply-chain audit, AI-modelintegriteitsscanning en runtime application self-protection (RASP). -**Model Leaderboard Snapshots:**Regelmatig bijgewerkte prestatiebenchmarks voor de nieuwste frontier-modellen op taken zoals ExploitGym, code-analyse en veilig refactoren, waarmee teams de capaciteit van zowel defensieve als offensieve AI kunnen begrijpen.
"We betreden een tijdperk waarin de ontwikkelaar die niet nauw verbonden is met een live, intelligente dreigingsfeed, opereert met een fatale blinde vlek. De intelligentie moet in de IDE stromen, niet alleen naar een dashboard."
Architectuurweerbaarheid in het Tijdperk van AI-Exploits
De technische realiteit van AI-gestuurde exploitatie vereist een fundamentele, niet-onderhandelbare aanname: je software zal worden gebruikt om kwetsbaarheden te vinden. Dit is geen falen van je engineering; het is een voorwaarde van de moderne omgeving. Daarom verschuift het primaire ontwerpdoel van "voorkom alle bugs" naar**"ontwerp systemen die weerbaar zijn onder aanhoudende, intelligente aanval."**
Dit principe vereist een gelaagde, pragmatische aanpak:
1. Neem Geheugenveilige Talen Incrementeel, maar Praktisch over
De ontdekking van 948 Linux-kernel-exploits is zwaar gericht op geheugencorruptiefouten in C. De strategische overstap naar Rust in de kernel, ondersteund door grote spelers, is niet langer een experimentele nice-to-have; het is een beveiligingsimperatief. Voor nieuwe user-space-projecten zouden Rust, Go of geheugenveilige subsets van C++ de standaard moeten zijn. Voor bestaande enorme codebases moeten nieuwe modules en beveiligingskritische parseerinterfaces worden gericht op een rewrite-first-aanpak.
2. Implementeer Capability-Based Security en Sterke Sandboxing
Vertrouw geen code, helemaal geen code. Of het nu een third-party bibliotheek is, een machine learning-inferentie-engine of een microservice in je mesh, bedien deze met het principe van de minste autoriteit. Gebruik seccomp-bpf, Landlock of op WASM gebaseerde runtime-sandboxes voor het uitvoeren van onvertrouwde logica. In de nasleep van de Lockdown Mode-omzeiling in ChatGPT is het duidelijk dat zelfs zwaar versterkte applicatiegrenzen kunnen falen. Een OS-level, capability-based handhaving van machtigingen biedt een tweede, sterkere verdedigingslinie.
3. Versterk de Supply Chain met Point-in-Time Integriteit
Traditionele ondertekening (bijv. npm-, PyPI-handtekeningen) verifieert de auteur, niet de veiligheid van de inhoud op een specifiek moment. AI kan kwetsbaarheden vinden en misbruiken in een pakket dat maanden geleden is ondertekend. Je hebt een point-in-time integriteitsverificatie nodig die de hash van een pakket combineert met een real-time kwetsbaarheids- en licentienalevingscontrole. Het model is binair: als een kwetsbaarheid met een CVSS-score boven 7.0 wordt ontdekt in een transitieve afhankelijkheid op een productiepad, moet de build mislukken.
4. Universele Geautomatiseerde Patch-Orkestratie
De gegevens over de implementatiesnelheid in bedrijven zijn een duidelijke oproep. Het is onaanvaardbaar dat een AI-ontdekte exploit met hoge ernst wekenlang ongepatcht blijft. De enige oplossing is om de patch-naar-implementatiepijplijn volledig te automatiseren met een strak afgebakend, geautomatiseerd canary-proces. Een klein percentage nodes ontvangt de patch. Als error budgets, metrieken en synthetische API-tests gedurende 60 minuten stabiel zijn, wordt de patch uitgerold naar de hele vloot. Vertrouwen op menselijke change-advisory boards in dit dreigingsklimaat is organisatorisch wangedrag.
De Diepgaande Duik: CVE-2026-66066 en het Libvips-Geheimenlek
Een concreet voorbeeld van de complexe, door AI exploiteerbare klasse van kwetsbaarheden is CVE-2026-66066, een subtiele fout in Rails' Active Storage. Op het eerste gezicht leek het een routinematige beeldverwerkingsbug. De kwetsbaarheid, geactiveerd bij gebruik van de high-performance libvips-bibliotheek, zorgde ervoor dat een speciaal gemaakt afbeeldingsbestand gevoelige applicatiegeheimen kon lekken.
De exploit-keten is een meesterwerk van multi-domein kennis die AI bij uitstek geschikt is om te synthetiseren:
- **Protocolanalyse:**De aanvaller uploadt een speciaal geconstrueerd SVG-bestand, een formaat dat wordt ondersteund door libvips.
- **Server-Side Request Forgery (SSRF):**De XML van de SVG verwijst naar een URL die wijst naar een interne metadata-instantie, zoals
http://169.254.169.254/latest/meta-data/op AWS. - Data Exfiltratie via een Nevenkanaal: Libvips verwerkt dit en voegt het resultaat in als onderdeel van de gerenderde uitvoer van de afbeelding, die vervolgens wordt opgeslagen in een S3-bucket die toegankelijk is voor de aanvaller.
Een statische analyser zou de SSRF kunnen markeren. Een beeldverwerkingsexpert zou zich zorgen kunnen maken over de complexiteit van SVG. Een AI-model kan deze verschillende concepten echter aan elkaar koppelen en een SVG maken die een specifieke optimalisatie van de libvips-loader gebruikt om een synchroon, op fouten gebaseerd lekken van het geheim rechtstreeks in een EXIF-gegevensveld op het verwerkte bestand te activeren. De remediëring vereiste het patchen van zowel Rails (voor strengere URL-validatie) als libvips (voor het verwijderen van gevaarlijke XML-functies).
De Toekomst is een Centaur-ModelOndanks de prestaties van GPT-6 Cyber op ExploitGym, is de directe toekomst niet een volledig autonome Skynet. Het is een centaur-model. De gevaarlijkste tegenstanders zijn hybride teams waarin een AI-model de uitputtende, grootschalige analyse uitvoert, door miljoenen regels kernelcode heen ploegt, duizend potentiële exploitatieprimitieven voorstelt, en een bekwame menselijke operator deze selecteert, het meest veelbelovende doelwit kiest, en de creatieve, omgevingsspecifieke finesse toevoegt.
Dit betekent dat het verdedigende team ook een centaur moet zijn. De AI-assistent van de ontwikkelaar van morgen is niet alleen een code-aanvuller; het is een actieve, adversariële pair programmer die realtime GPT-6-niveau analyse uitvoert op elke pull request. Het markeert niet alleen syntaxisfouten maar ook complexe logische ketens die geëxploiteerd kunnen worden, voert symbolisch nieuwe aanvalspaden uit, en genereert automatisch een patch en de bijbehorende regressietest voordat een menselijke beoordelaar de diff zelfs maar heeft uitgelezen.
Het tijdperk van de 978 adviezen, de 948 kernel-exploits en de 48,5% ExploitGym-score is geen verre waarschuwing. Het is een live-oefening waar we allemaal al in zitten. De enige haalbare reactie is een radicale, datagestuurde versnelling van defensieve engineering, gekoppeld aan een nederige aanvaarding dat intelligentie, net als code, kan worden geforkt voor goed of voor kwaad.