
KI-gestützte Exploit-Entwicklung: Die sich wandelnde Cyber-Bedrohungslandschaft und was Entwickler im Jahr 2025 wissen müssen
Im sich rasant verändernden Bereich der Cybersicherheit ist künstliche Intelligenz nicht länger eine theoretische Kuriosität, sondern zu einem zweiseitig nutzbaren Instrument von tiefgreifender Bedeutung geworden. Die neueste Grenze, KI-gestützte Exploit-Entwicklung, beschleunigt nicht nur die Schwachstellenerkennung, sondern schreibt die Regeln der offensiven und defensiven Sicherheit grundlegend neu. Von geschlossenen Forschungslaboren bis zu den vordersten Linien der Software-Lieferketten – die Auswirkungen erfordern sofortige Aufmerksamkeit von Entwicklern.
Dieser Artikel seziert die technischen Realitäten neu entstehender KI-Systeme, einschließlich des hochleistungsfähigen GPT-6 Cyber-Modells, und übersetzt sie in umsetzbare Ingenieursprinzipien. Wir werden die harten Daten hinter den neuartigen Schwachstellenzahlen, die beunruhigenden Statistiken zur Verzögerung bei der Bereitstellung von Patches und die architektonischen Veränderungen untersuchen, die erforderlich sind, um widerstandsfähige Systeme in einer Ära von Angriffen mit Maschinengeschwindigkeit zu bauen.
Das Aufkommen hochleistungsfähiger offensiver KI
Seit über einem Jahrzehnt unterstützen Fuzzing- und statische Analysetools bei der Fehlersuche. Was die aktuelle Welle unterscheidet, ist der Sprung von der Erkennung zur autonomen Ausnutzung. Frühe KI-Modelle konnten potenzielle Pufferüberläufe mit hohen Falsch-Positiv-Raten markieren. Die heutigen Grenzmodelle können eine komplexe Codebasis aufnehmen, Datenflüsse durch mehrere Abstraktionsebenen verfolgen und einen funktionierenden, ausgefeilten Proof-of-Concept-Exploit generieren, oft schneller als ein erfahrener Sicherheitsforscher.
Die jüngste Analyse der SecureWorks Counter Threat Unit hebt einen kritischen Wendepunkt hervor: Von KI gefundene Fehler sind nicht länger akademisch. Die Daten zeigen, dass 1,3 Prozent der von KI entdeckten Schwachstellen in freier Wildbahn bewaffnetwurden, eine Zahl, die voraussichtlich steigen, aber bis Ende 2027 unter fünf Prozent bleiben wird. Dieser scheinbar niedrige Prozentsatz ist trügerisch; er stellt eine Vorhut von hochgradig gezielten, potenziell katastrophalen Angriffen dar, nicht eine Massenausnutzung. Die Qualität dieser Exploits, die oft komplexe Logikketten nutzen, die für traditionelle Scanner unsichtbar sind, stellt eine ernste Bedrohung für hochwertige Vermögenswerte dar.
Analyse des ExploitGym-Benchmarks
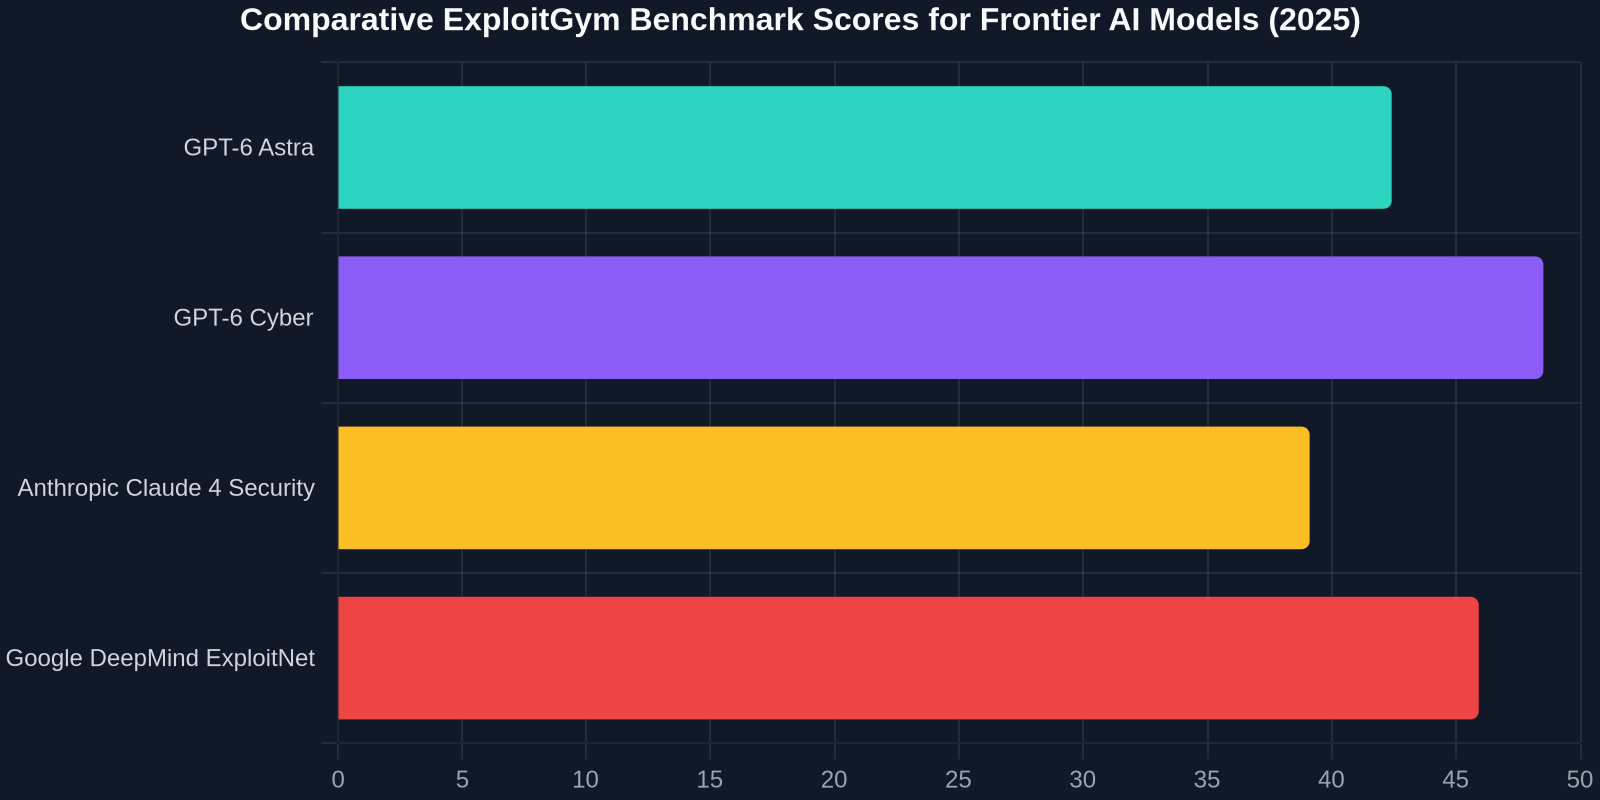
Um die Modellfähigkeit zu verstehen, hat die Branche strenge, simulierte Umgebungen übernommen. Der ExploitGym-Benchmark dient als endgültiger Test, der KI-Agenten mit einer Vielzahl von Capture-the-Flag (CTF)-artigen und realen binären Exploitation-Herausforderungen konfrontiert. Dazu gehören Heap Feng Shui, Format-String-Angriffe und die Ausnutzung von Race Conditions auf modernen Linux-Kerneln.
Der Leistungssprung zwischen den jüngsten Modelliterationen ist deutlich. OpenAIs GPT-6 Astra, obwohl ein leistungsstarker Generalist, erzielte eine Erfolgsquote von 42,4 %. Die domänenspezifische Feinabstimmung vonGPT-6 Cyber, die exklusiv ausgewählten Partnern wie Daybreak Red zur Verfügung steht, steigerte seine Punktzahl jedoch auf 48,5 %. Diese Kennzahl bedeutet einen Durchbruch: eine KI, die bei fast der Hälfte aller hochschwierigen Exploitation-Aufgaben ohne menschliches Eingreifen erfolgreich sein kann. Das Modell erreicht dies durch fortgeschrittene Programmsynthese, indem es dynamisch ROP-Ketten aufbaut und moderne Schutzmaßnahmen wie ASLR und Stack Canaries in der Simulation umgeht.
Eine neue Generation von Bedrohungsinformationen: Die 978 Advisories
Seit 2025 hat das Ökosystem der Cybersicherheitsinformationen eine erzwungene Evolution durchgemacht, um der Geschwindigkeit KI-gesteuerter Bedrohungen gerecht zu werden. Eine kuratierte Datenbank ist entstanden, die 978 Entwickler-Advisoriesumfasst, jedes ein sorgfältig dokumentierter Vorfall, der ausgenutzte Fehler, Lieferkettenangriffe, größere Sicherheitsverletzungen und Schwachstellen abdeckt, die von KI-Codierungswerkzeugen selbst eingeführt wurden. Dies ist kein statischer CVE-Feed; es ist ein lebendiges Repository, das Live-CVE-Scores, IoC-Muster (Indikatoren für eine Kompromittierung) und, entscheidend, präskriptive Minderungsschritte bereitstellt.
Dieses Kompendium dient als neue Pflichtlektüre für jeden CISO oder leitenden Ingenieur. Die thematische Aufschlüsselung ist alarmierend:
-**Lieferketten-Kompromittierungen:**Angriffe, die auf Paketmanager, CI/CD-Pipeline-Tools und Übernahmen von Open-Source-Bibliotheken abzielen, stellen einen signifikanten Teil dieser Advisories dar. Gegner nutzen KI, um nach Typosquatting-Möglichkeiten zu suchen und bösartigen Code in weit verbreitete npm- und PyPI-Pakete einzuschleusen. -KI-Tool-Fehler: Eine spezifische, schnell wachsende Kategorie deckt Schwachstellen in KI-Systemen ab. Dies umfasst Prompt-Injection, die zu Remote-Code-Ausführung in LLM-gestützten Plugins führt, Data-Poisoning-Angriffe und Modellinversionstechniken, die sensible Trainingsdaten extrahieren. Ein detaillierter Bericht offenbarte beispielsweise eine inzwischen gepatchte Schwachstelle im Lockdown-Modus von OpenAI ChatGPT, einer Funktion, die den Zugriff auf sensible Daten einschränken soll. Forscher zeigten, dass eine sorgfältig konstruierte, mehrschrittige Prompt-Sequenz diese Schutzmaßnahmen umgehen und zugrunde liegende Systemkonfigurationen offenlegen konnte.
- **Zero-Day-Ketten:**Die Advisories dokumentieren häufig die Verkettung einer von KI entdeckten Schwachstelle (oft ein komplexer Speicherkorruptionsfehler) mit einer Human-in-the-Loop-Technik für die endgültige Payload-Zustellung, was eine Centaur-Modell-Angriffsmethodik zeigt.
Fallstudie im Fokus: Der Firefox- und Linux-Kernel-Sommer
Kein einzelnes Ereignis veranschaulicht den Paradigmenwechsel besser als die jüngsten Entdeckungen, die Grenzmodellen zugeschrieben werden. Während eines konzentrierten Forschungs-Sprints wurde eine Modellvariante damit beauftragt, die Codebasen von Mozilla Firefox und des Linux-Kernels zu prüfen, zwei der am meisten geprüften und sicherheitskritischsten Open-Source-Projekte der Welt.
Die Ergebnisse schickten eine Schockwelle durch die Sicherheitsgemeinschaft:
81 neuartige Firefox-Schwachstellen
Das Modell entdeckte atemberaubende81 neuartige Schwachstellenin Firefox. Es handelte sich nicht um Doppelfunde bekannter Fehlerklassen. Die detaillierte Nachbetrachtung zeigte eine Häufung von komplexen Use-After-Free-Fehlern in der DOM- und Layout-Engine, Logikfehlern in der IPC-Sanitisierung (Interprozesskommunikation) und neuartigen Race Conditions in der WebGPU-Implementierung. Das Modell demonstrierte eine unheimliche Fähigkeit, Multi-Komponenten-Interaktionen zu verstehen, eine traditionelle Schwachstelle statischer Analysewerkzeuge. Jeder Fund wurde mit einer prägnanten, automatisch generierten und größtenteils genauen Ursachenanalyse geliefert, was die Triage-Last für Mozilla-Ingenieure drastisch reduzierte.
948 funktionierende Linux-Kernel-Exploits
Der tiefe Einblick in den Linux-Kernel war noch produktiver. Die KI entwickelte funktionierende Privilegieneskalations-Exploits für948 verschiedene Schwachstellen. Dieses Volumen ist beispiellos. Das Exploit-Korpus reichte von klassischen Heap-Überläufen in veralteten ioctl-Handlern, die langsam umgestaltet werden, aber immer noch zahlreich sind, bis hin zu komplizierten Logikfehlern in neuen eBPF-Verifizierer-Subsystemen. Die Fähigkeit des Modells, zuverlässige, universell kompatible Exploits über eine Vielzahl von Kernel-Konfigurationen hinweg zu generieren (einschließlich gehärteter wie denen, die von Android und ChromeOS verwendet werden), demonstriert ein Niveau systematischen Denkens, das zuvor als exklusiv für die elitärsten menschlichen Teams galt.
Die Bereitstellungslücke: Ein menschliches Prozessversagen in einer Welt mit KI-GeschwindigkeitDie Revolution bei der Entdeckung von Schwachstellen ist völlig unvereinbar mit der Entwicklung unserer Patch-Management-Lebenszyklen. Die unbestreitbare technische Leistung der KI bei der Findung und Ausnutzung von Fehlern wird tragischerweise durch ein seit langem bestehendes, gut verstandenes und unerträglich hartnäckiges menschliches und prozessuales Versagen ermöglicht: langsames Patchen.
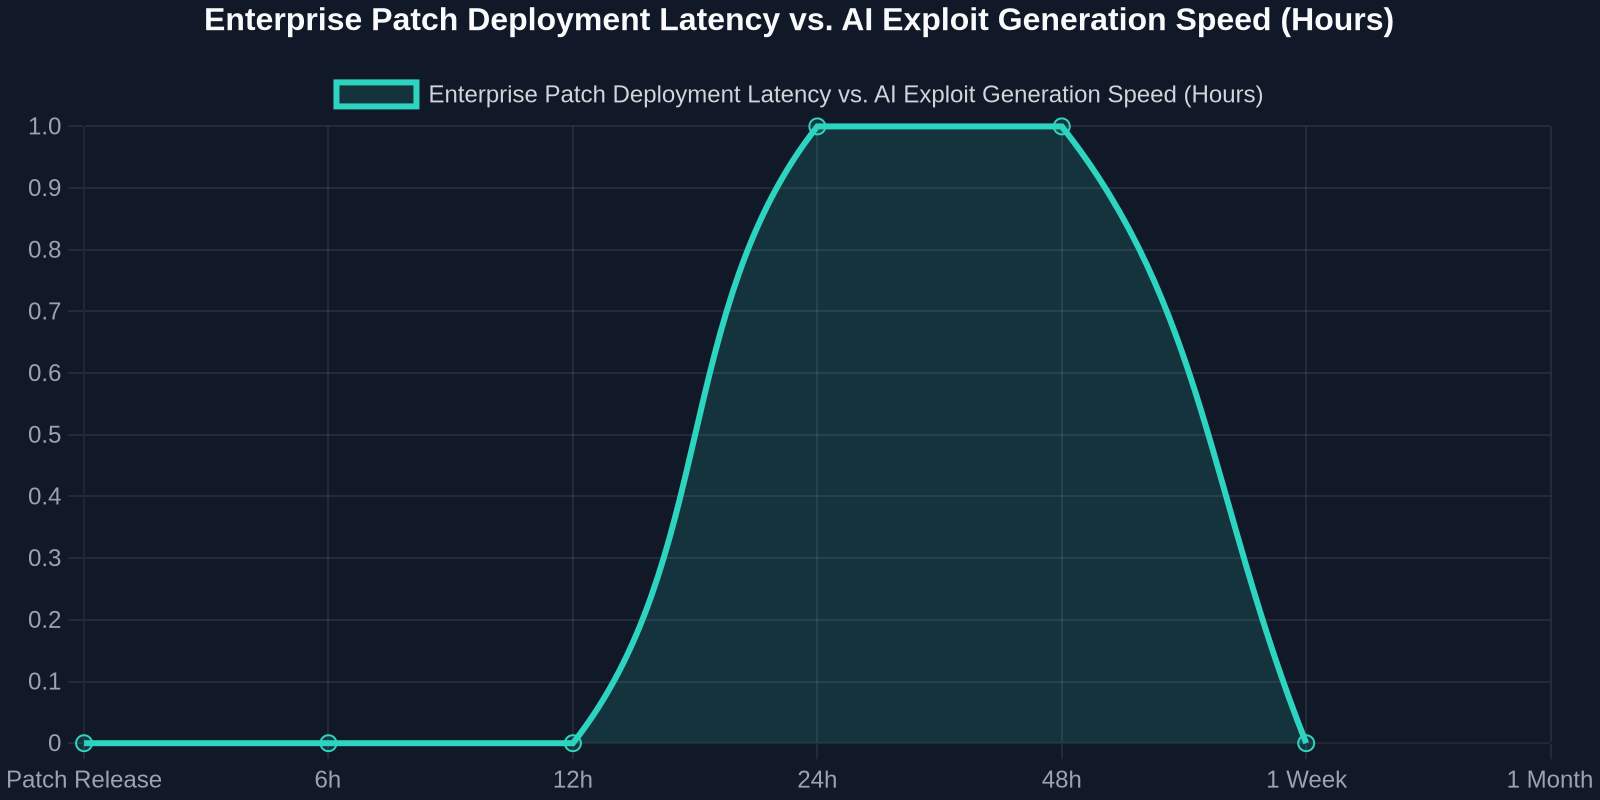
Die Daten offenbaren ein erschreckendes Expositionsfenster. Wenn ein kritisches Windows-Sicherheitsupdate veröffentlicht wird, oft als Reaktion auf eine bestätigte, aktiv ausgenutzte Schwachstelle, beginnt das Rennen. Doch die Telemetrie von Unternehmen zeigt durchweg, dass weniger als die Hälfte aller Unternehmensgerätedas Update innerhalb der ersten kritischen Woche installieren. Der Ausläufer ist lang und dick; eine erhebliche Minderheit von Assets bleibt monatelang ungepatcht.
Dies erzeugt eine katastrophale Verzögerung, bei der:
- Eine KI entdeckt eine Schwachstelle am Tag 0.
- Ein Anbieter veröffentlicht einen Patch am Tag 15.
- Ein vollständig waffenfähiger KI-Exploit wird am Tag 20 veröffentlicht oder verkauft.
- Eine Mehrheit der Systeme bleibt bis zum Tag 60 oder später verwundbar.
Diese Bereitstellungslücke ist der größte einzelne Multiplikator für KI-getriebene Risiken. Die technische Fähigkeit, schnell zu patchen, existiert durch moderne CI/CD- und gestaffelte Rollout-Infrastruktur. Die Barriere sind operative Trägheit, Angst vor Regressionen und ein Mangel an automatisierten Canary-Tests, die den Betreibern sofortiges Vertrauen in die Sicherheit des Updates geben können.
| Security Posture | Old-World Response Time | Required AI-Era Response Time | Primary Bottleneck |
|---|---|---|---|
| Standard CVE Patching | 30-90 days | < 24 hours | Manual testing/change windows |
| Zero-Day Containment | Hours to days | Instantaneous/automated rollback | Detection latency |
| AI Tool Vulnerability Fix | Weeks (model retraining) | Runtime guardrails in hours | Model deployment pipelines |
123456.ai: Ein Schutzschild und Kompass für Entwickler
Als direkte Reaktion auf diese Informationsasymmetrie sind Plattformen wie123456.aials operative Drehscheiben für Entwickler und Sicherheitsingenieure entstanden. Weit mehr als ein Nachrichtenaggregator repräsentiert sie eine neue Kategorie einer zweisprachigen KI-Intelligence- und Ressourcenplattform, die auf Geschwindigkeit und Handlungsfähigkeit ausgelegt ist.
Die Tool-Suite ist gezielt für den modernen Entwickler konzipiert: -**Täglich kuratierte Advisories:**Ein Echtzeit-Feed, der den 978-Advisory-Datenstrom filtert und Bedrohungen basierend auf Ihrem Tech-Stack kontextualisiert (z. B. „Kritische CVE in Rails Active Storage mit Exploit-Code in freier Wildbahn, der gegen libvips läuft“). -**Kategorisiertes Tools-Verzeichnis:**Ein lebendiger Index der besten Open-Source- und kommerziellen Sicherheitstools, kategorisiert nach Anwendungsfall, Supply-Chain-Audit, KI-Modell-Integritätsscanning, Laufzeit-Anwendungsselbstschutz (RASP). -**Model-Leaderboard-Snapshots:**Regelmäßig aktualisierte Leistungsbenchmarks für die neuesten Frontier-Modelle bei Aufgaben wie ExploitGym, Code-Analyse und sicherem Refactoring, die Teams helfen, die Fähigkeiten sowohl defensiver als auch offensiver KI zu verstehen.
„Wir treten in eine Ära ein, in der der Entwickler, der nicht eng mit einem lebendigen, intelligenten Bedrohungsfeed verbunden ist, mit einem fatalen blinden Fleck arbeitet. Die Intelligenz muss in die IDE fließen, nicht nur in ein Dashboard.“
Architektonische Resilienz im Zeitalter von KI-Exploits
Die technische Realität KI-getriebener Ausnutzung erfordert eine grundlegende, nicht verhandelbare Annahme: Ihre Software wird verwendet werden, um Schwachstellen zu finden. Das ist kein Versagen Ihrer Entwicklung; es ist eine Bedingung der modernen Umgebung. Daher verschiebt sich das primäre Designziel von „alle Fehler verhindern“ zu**„Systeme entwerfen, die unter anhaltendem, intelligentem Angriff widerstandsfähig sind.“**
Dieses Prinzip erfordert einen mehrschichtigen, pragmatischen Ansatz:
1. Speichersichere Sprachen schrittweise, aber praktisch einführen
Die Entdeckung von 948 Linux-Kernel-Exploits ist stark auf Speicherkorruptionsfehler in C ausgerichtet. Der strategische Wechsel zu Rust im Kernel, unterstützt von großen Akteuren, ist kein experimentelles Nice-to-have mehr; es ist ein Sicherheitsgebot. Für neue User-Space-Projekte sollten Rust, Go oder speichersichere Teilmengen von C++ der Standard sein. Für bestehende massive Codebasen sollten neue Module und sicherheitskritische Parsing-Schnittstellen für einen Rewrite-First-Ansatz ins Visier genommen werden.
2. Capability-basierte Sicherheit und starkes Sandboxing implementieren
Vertrauen Sie keinem Code, absolut keinem Code. Ob es sich um eine Drittanbieter-Bibliothek, eine Machine-Learning-Inferenz-Engine oder einen Microservice in Ihrem Mesh handelt, betreiben Sie ihn nach dem Prinzip der geringsten Rechte. Verwenden Sie seccomp-bpf, Landlock oder WASM-basierte Laufzeit-Sandboxes für die Ausführung nicht vertrauenswürdiger Logik. Nach der Umgehung des Lockdown-Modus in ChatGPT ist klar, dass selbst stark befestigte Anwendungsgrenzen versagen können. Eine auf OS-Ebene capability-basierte Durchsetzung von Berechtigungen bietet eine zweite, stärkere Verteidigungslinie.
3. Die Lieferkette mit Point-in-Time-Integrität härten
Traditionelle Signaturen (z. B. npm-, PyPI-Signaturen) verifizieren den Autor, nicht die Sicherheit des Inhalts zu einem bestimmten Zeitpunkt. KI kann Schwachstellen in einem Paket finden und ausnutzen, das vor Monaten signiert wurde. Sie benötigen eine Point-in-Time-Integritätsprüfung, die den Hash eines Pakets mit einer Echtzeit-Schwachstellen- und Lizenzkonformitätsprüfung kombiniert. Das Modell ist binär: Wenn eine Schwachstelle mit einem CVSS-Score über 7.0 in einer transitiven Abhängigkeit auf einem Produktionspfad entdeckt wird, muss der Build fehlschlagen.
4. Universelle automatisierte Patch-Orchestrierung
Die Daten zur Bereitstellungsgeschwindigkeit in Unternehmen sind ein Weckruf. Es ist inakzeptabel, dass ein hochgradig schwerwiegender, von KI entdeckter Exploit wochenlang ungepatcht bleibt. Die einzige Lösung besteht darin, die Patch-zu-Bereitstellung-Pipeline mit einem eng begrenzten, automatisierten Canary-Prozess vollständig zu automatisieren. Ein kleiner Prozentsatz der Knoten erhält den Patch. Wenn Fehlerbudgets, Metriken und synthetische API-Tests 60 Minuten lang stabil sind, wird der Patch auf die gesamte Flotte ausgerollt. Sich in diesem Bedrohungsklima auf menschliche Change-Advisory-Boards zu verlassen, ist organisatorisches Fehlverhalten.
Der Deep Dive: CVE-2026-66066 und der Libvips-Geheimnisverlust
Ein konkretes Beispiel für die komplexe, KI-ausnutzbare Klasse von Schwachstellen ist CVE-2026-66066, ein subtiler Fehler in Rails' Active Storage. Oberflächlich betrachtet schien es ein routinemäßiger Bildverarbeitungsfehler zu sein. Die Schwachstelle, die bei Verwendung der Hochleistungsbibliothek libvips ausgelöst wird, ermöglichte es einer manipulierten Bilddatei, sensible Anwendungsgeheimnisse preiszugeben.
Die Exploit-Kette ist ein Meisterwerk domänenübergreifenden Wissens, das KI in einzigartiger Weise synthetisieren kann:
- **Protokollanalyse:**Der Angreifer lädt eine speziell konstruierte SVG-Datei hoch, ein von libvips unterstütztes Format.
- **Server-Side Request Forgery (SSRF):**Das XML der SVG referenziert eine URL, die auf eine interne Metadateninstanz verweist, wie z. B.
http://169.254.169.254/latest/meta-data/auf AWS. - Datencxfiltration über einen Seitenkanal: Libvips verarbeitet dies und bettet das Ergebnis als Teil der gerenderten Ausgabe des Bildes ein, das dann in einem für den Angreifer zugänglichen S3-Bucket gespeichert wird.
Ein statischer Analyzer könnte die SSRF kennzeichnen. Ein Bildverarbeitungsexperte könnte sich über die SVG-Komplexität Sorgen machen. Ein KI-Modell jedoch kann diese unterschiedlichen Konzepte miteinander verketten und ein SVG erstellen, das eine spezifische libvips-Loader-Optimierung nutzt, um eine synchrone, fehlerbasierte Offenlegung des Geheimnisses direkt in ein EXIF-Datenfeld der verarbeiteten Datei auszulösen. Die Behebung erforderte das Patchen sowohl von Rails (für strengere URL-Validierung) als auch von libvips (zum Entfernen gefährlicher XML-Funktionen).
Die Zukunft ist ein Zentaur-ModellFür all die Leistung von GPT-6 Cyber auf ExploitGym ist die unmittelbare Zukunft kein vollständig autonomes Skynet. Es ist ein Zentaur-Modell. Die gefährlichsten Gegner sind hybride Teams, bei denen ein KI-Modell die erschöpfende Analyse in großem Maßstab durchführt, Millionen von Zeilen Kernel-Code durchforstet, tausend potenzielle Exploit-Primitive vorschlägt und ein erfahrener menschlicher Operator diese kuratiert, das vielversprechendste Ziel auswählt und die kreative, umgebungsspezifische Finesse hinzufügt.
Das bedeutet, dass das Verteidigungsteam ebenfalls ein Zentaur sein muss. Der KI-Assistent des Entwicklers von morgen ist nicht nur ein Code-Vervollständiger; es ist ein aktiver, gegnerischer Pair-Programmierer, der in Echtzeit eine GPT-6-Level-Analyse jedes Pull-Requests durchführt. Es markiert nicht nur Syntaxfehler, sondern auch komplexe Logikketten, die ausgenutzt werden könnten, führt symbolische Ausführung neuer Angriffspfade durch und generiert automatisch einen Patch sowie den entsprechenden Regressionstest, bevor ein menschlicher Prüfer den Diff überhaupt zu Ende gelesen hat.
Die Ära der 978 Advisories, der 948 Kernel-Exploits und der 48,5 % ExploitGym-Punktzahl ist keine ferne Warnung. Es ist eine Live-Fire-Übung, an der wir alle bereits teilnehmen. Die einzig tragfähige Antwort ist eine radikale, datengesteuerte Beschleunigung der defensiven Entwicklung, gepaart mit einer demütigen Akzeptanz, dass Intelligenz, wie Code, sowohl zum Guten als auch zum Bösen abgespalten werden kann.